CAUSA RAÍZ, IMPULSADA POR AGENTIC NETOPS
La disminución MTTR con IA segura y controlada para la resolución de problemas de red.
Cada minuto que se dedica a buscar la causa raíz es un minuto que no se dedica a prevenir interrupciones de la red ni a respaldar las iniciativas empresariales. Con Agents, identifique el incidente entrante en su red activa y rastree directamente la causa raíz en lugar de basarse en suposiciones.

Un agente diagnostica. La automatización determinista soluciona los problemas.
No todos los incidentes requieren a su mejor ingeniero o a su agente más caro. Un determinista Runbook Resuelve automáticamente los problemas conocidos, y solo los incidentes verdaderamente novedosos o complejos se derivan a Diagnóstico Profundo, lo que ahorra costes y libera tiempo para sus mejores ingenieros.
- Para obtener mejores resultados, utilice una plataforma basada en el contexto real y la finalidad de su red.
- Calcula las rutas en tiempo real, revelando lo que sucede en tu red, no lo que indican las configuraciones (por ejemplo, enrutamiento asimétrico, conmutación por error, redireccionamientos de políticas).
- Revise el análisis de la causa raíz y la recomendación en un lenguaje sencillo.
- Aprovecha las habilidades que hayas generado y cualquier sistema ITSM y de observabilidad conectado, como ServiceNow o Dynatrace, para obtener contexto adicional.
- Cree flujos de trabajo repetibles con el Runbook Agente complementario después del diagnóstico.
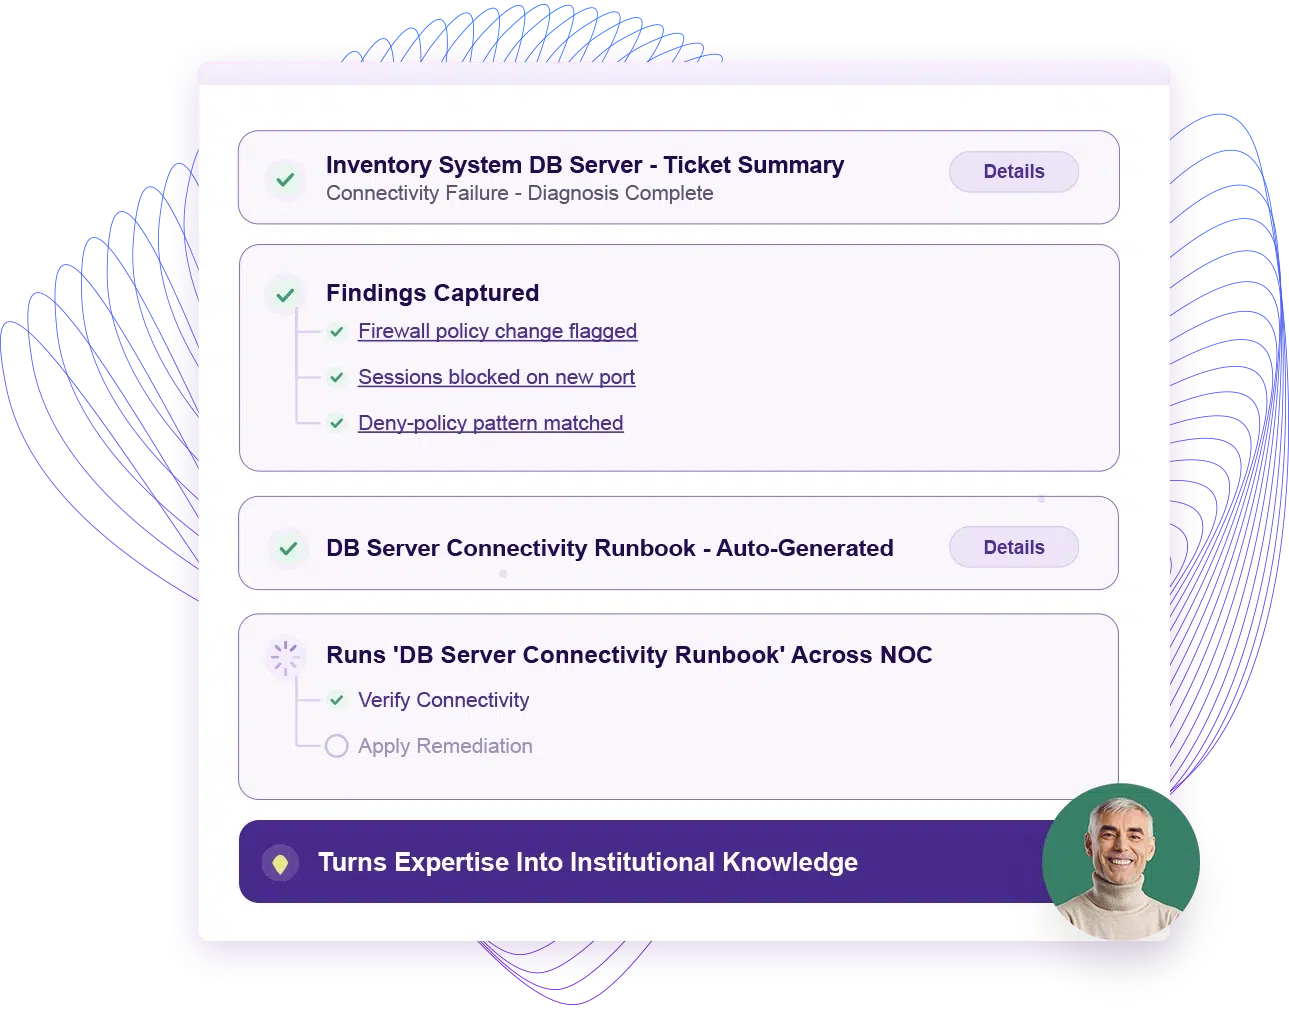
Un ciclo de aprendizaje acumulativo convierte cada diagnóstico en un agente más inteligente.
Cada vez que un ingeniero sénior trabaja en algo nuevo, ese conocimiento no se queda encerrado en la cabeza de una sola persona. NetBrain lo convierte en un runbook Todo el NOC puede funcionar.
Con el tiempo, el NOC gestiona más tareas por sí mismo mediante la automatización determinista, y los ingenieros sénior dedican más tiempo a problemas complejos y nuevas iniciativas.
Deja que los tickets anteriores guíen el aprendizaje. Convierte el historial de tickets y la memoria de diagnósticos en reglas de prevención automatizadas y habilidades para la resolución de problemas.
Ese es el ciclo de aprendizaje: cada incidente resuelto se convierte en una automatización validada y reutilizable, por lo que la siguiente ocurrencia cuesta menos prevenirla y requiere menos tiempo para resolverse. El NOC pasa de un enfoque reactivo a uno preventivo y proactivo, una resolución a la vez.
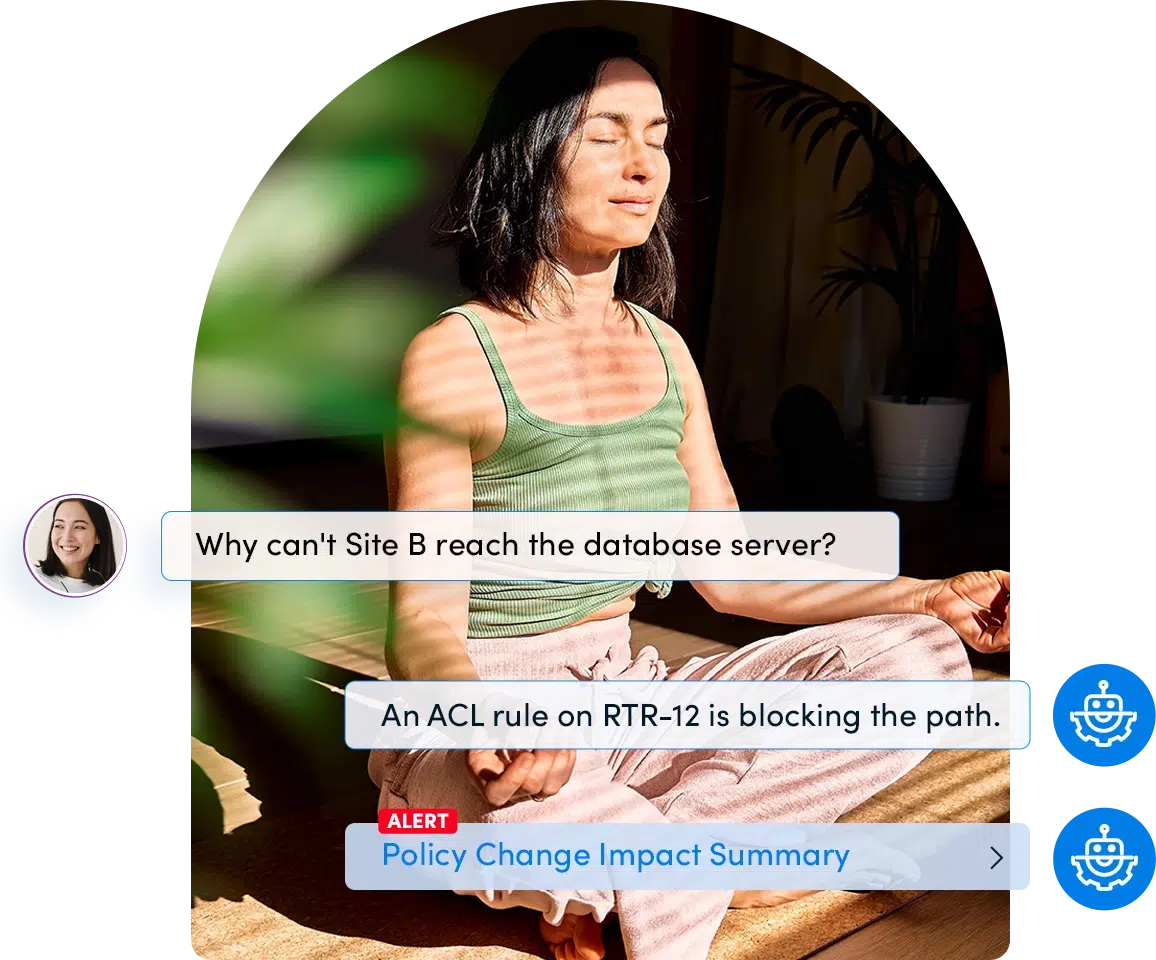
Diagnóstico en lenguaje sencillo para todos los ingenieros.
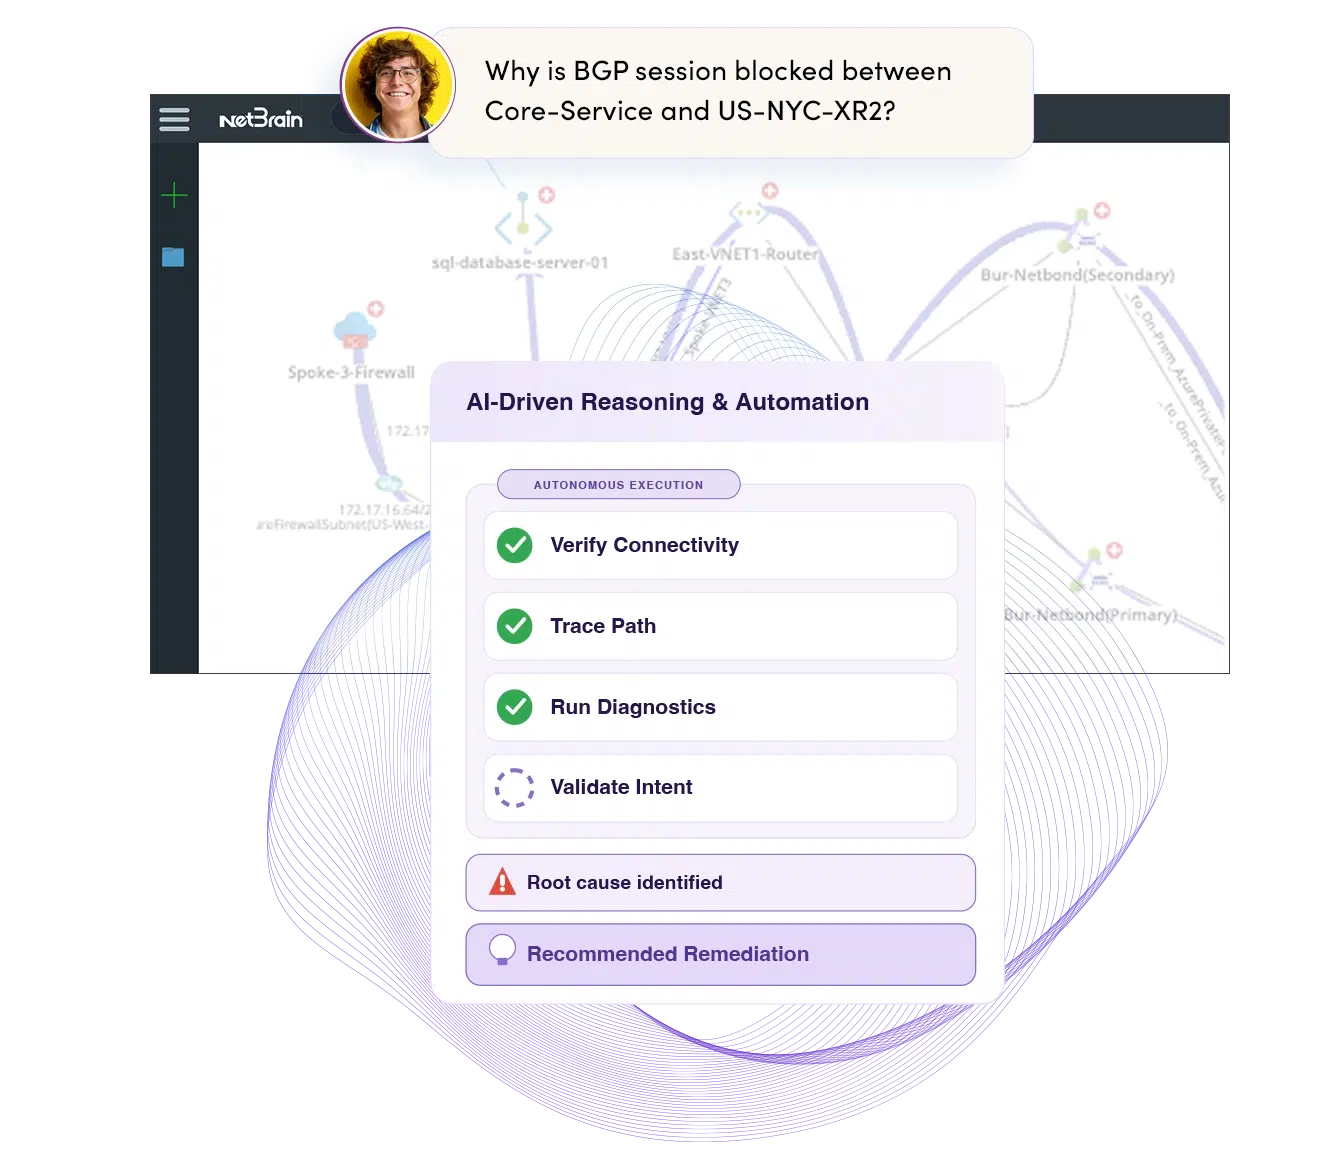
Los agentes de IA permiten a los ingenieros introducir un problema en lenguaje natural y obtener un diagnóstico. Basta con preguntarle qué ocurre en lenguaje natural para observar cómo realiza las mismas comprobaciones que un experto, pero en mucho menos tiempo: accesibilidad de las capas 2 y 3, cambios en las políticas, reglas ACL mal configuradas. Responde a todas las preguntas de forma transparente.
Cada respuesta se muestra paso a paso, ya que el Diagnóstico Profundo razona utilizando herramientas diseñadas específicamente para este fin y basadas en el contexto real de su red. Incluso proporciona la acción recomendada a seguir, incluyendo instrucciones.
Una vez que Deep Diagnosis encuentre la causa raíz, pásela al agente de cambio con un solo clic para generar un cambio determinista ejecutable de forma segura. runbook (verificación previa, ejecución, verificación posterior, comparación, documentación), sin tocar los dispositivos.
Consulte la sección «Realizar cambios seguros en la red» para explorar con más detalle los flujos de trabajo de agentes controlados. La autonomía se adquiere gradualmente: comience con intervención humana, extiéndala a control humano a medida que aumente la confianza, tarea por tarea.
Esta plataforma nos ayudó a crear flujos de trabajo y, al ser sin código, no requiere programación. Así, podemos centrarnos en configurar nuestros flujos de trabajo. Los principales beneficios de esta herramienta son la validación de la red, los diagramas y la posibilidad de diagnosticar y solucionar problemas en caso de que surja alguno.
DEVSECOPSServicios de TI
Leer reviews




Preguntas frecuentes
- ¿Qué MTTR ¿Qué significa esto y por qué es importante para los equipos de red?
-
MTTR El tiempo medio de reparación (Mean Time to Repair) es el tiempo promedio que se tarda en resolver completamente un incidente de red, desde su detección hasta su restauración. MTTR Esto significa menos tiempo de inactividad y menos trabajo de extinción de incendios por incidente.
- ¿Cómo NetBrainEl agente de diagnóstico profundo de reduce MTTR?
-
Un ingeniero formula una pregunta a Deep Diagnosis a través de AI Copilot, y este razona mediante la red en tiempo real, solicitando información contextual faltante en lugar de adivinar. Devuelve la causa raíz en lenguaje sencillo e indica la automatización correspondiente que ya está implementada en el sistema. MTTR Las cifras disminuyen porque los ingenieros dedican menos tiempo a recopilar información y más tiempo a actuar en función de la respuesta.
- ¿Cuál es la diferencia entre el Agente de Diagnóstico Profundo y el Runbook ¿Agente acompañante?
-
El agente de diagnóstico profundo encuentra la causa raíz de incidentes complejos o novedosos. Transfiera el diagnóstico a un Runbook mediante el Runbook Agente complementario, para futuras ventanas de diagnóstico y cambio automatizadas.
- ¿Automatizar la resolución de problemas de red implica reemplazar nuestras herramientas de monitorización actuales?
-
No. NetBrain funciona junto con su pila de monitoreo, ITSM y observabilidad existente. Las API REST y los webhooks manejan conexiones personalizadas y MCP permite NetBrain Intercambia el contexto de la red en tiempo real directamente con herramientas como ServiceNow, Dynatrace, BigPanda y Selector, añadiendo la capa de diagnóstico y automatización que esas herramientas no ofrecen por sí solas.
- ¿Con qué rapidez podemos esperar? MTTR ¿Mejorar después de la implementación?
-
Varía según la complejidad de la red y la cantidad de tipos de incidentes que ya están codificados. Runbooks. Los tipos de incidentes de mayor volumen suelen mejorar primero.
- ¿La reducción? MTTR ¿También ayuda a prevenir interrupciones en la red?
-
A menudo, sí. El agente de evaluación crea todo lo necesario para comprobar automáticamente en toda la red la misma causa raíz, de modo que el mismo incidente se detecta y se gestiona antes de que se convierta en una interrupción total del servicio.